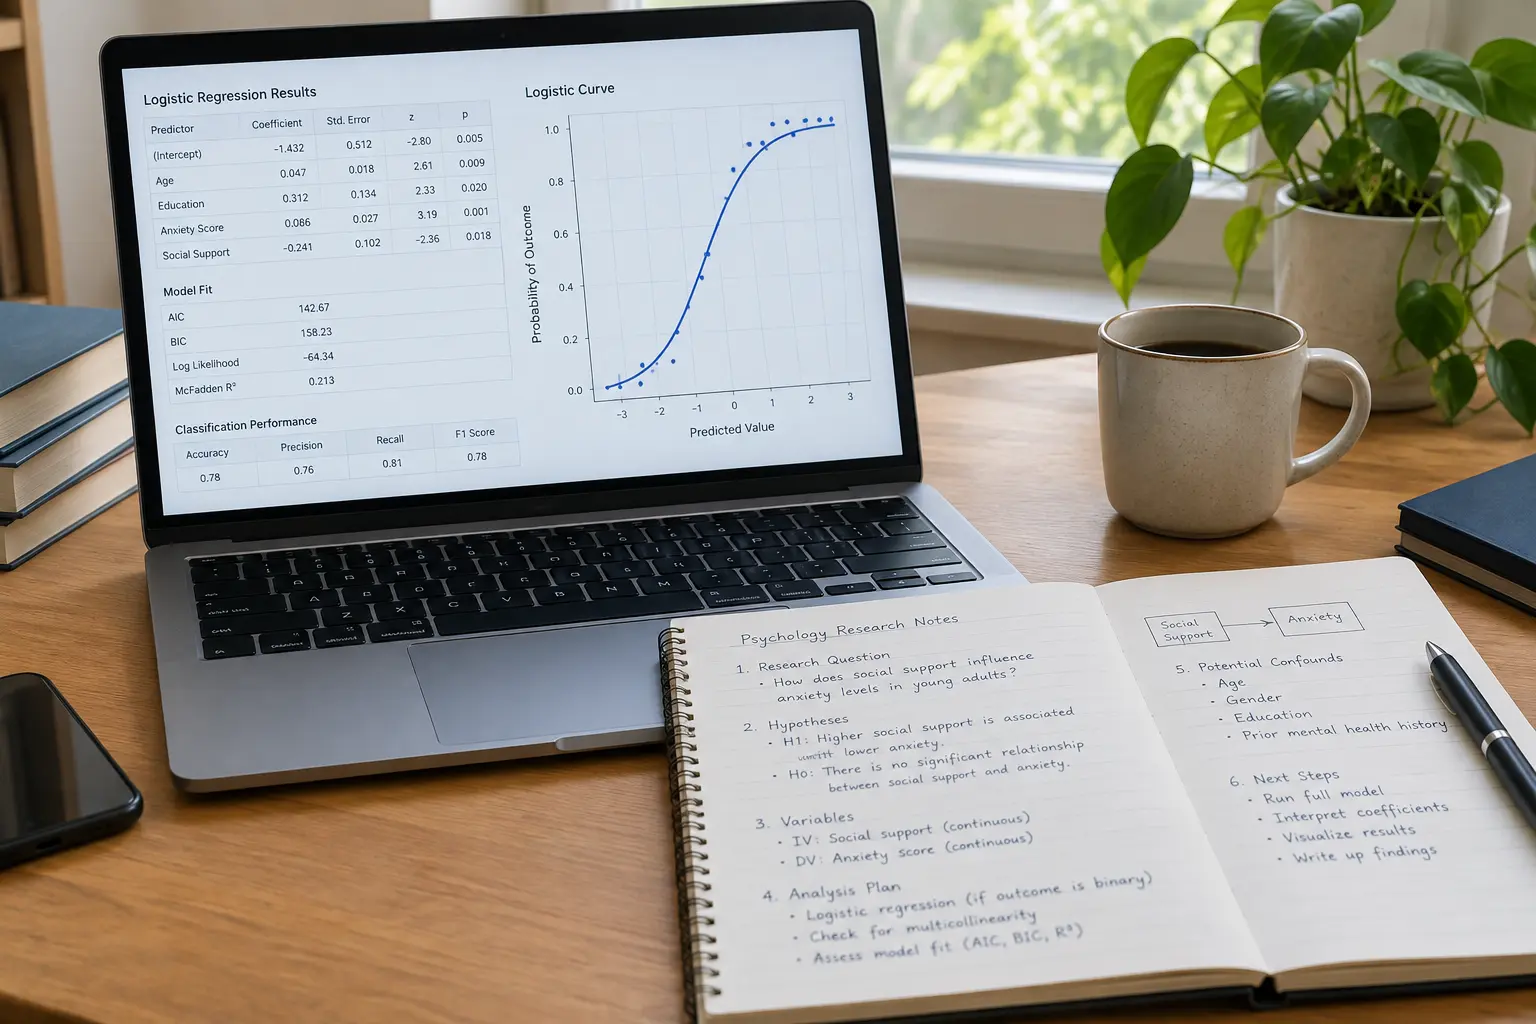
Si tu variable dependiente tiene solo dos categorías —abandono sí/no, adherencia al tratamiento sí/no, aprobación de una prueba sí/no— la regresión lineal no es la herramienta correcta, por más que tengas predictores continuos y todo el resto del diseño armado. Ahí es donde entra la regresión logística, un análisis que suele generar devoluciones cuando se aplica mal en una tesina de Psicología y que conviene dominar cuando el director/a quiere ver que sabés justificar la elección del modelo y no solo correr un botón en SPSS.
Esta guía explica cuándo conviene usar la regresión logística en tu tesina, en qué se diferencia de la lineal, cómo se interpretan sus coeficientes y qué supuestos tenés que verificar antes de presentarla ante el jurado, con un ejemplo ilustrativo aplicado a Psicología.
¿Cuándo conviene usar regresión logística en tu tesina de Psicología?
La regresión logística binaria sirve cuando tu variable dependiente es dicotómica (dos categorías, codificadas 0 y 1) y querés estimar la probabilidad de que ocurra el evento en función de una o más variables independientes, que pueden ser continuas o categóricas. En Psicología aparece con frecuencia en preguntas como: ¿la ansiedad rasgo y el apoyo social percibido predicen la deserción universitaria (sí/no) en estudiantes de primer año? ¿el nivel de burnout y la antigüedad laboral predicen la intención de abandono del puesto (sí/no) en un equipo de salud?
Si tu variable dependiente tiene más de dos categorías no ordenadas (por ejemplo, tipo de estrategia de afrontamiento elegida entre tres opciones), corresponde una regresión logística multinomial; si las categorías tienen un orden natural (bajo/medio/alto), una regresión logística ordinal. Ambas variantes existen en SPSS, jamovi y R, pero en tesinas de grado es habitual trabajar con la binaria, porque responde bien a preguntas de investigación acotadas y es más fácil de defender ante el jurado.
Regresión logística vs. regresión lineal: la diferencia que hay que saber explicar
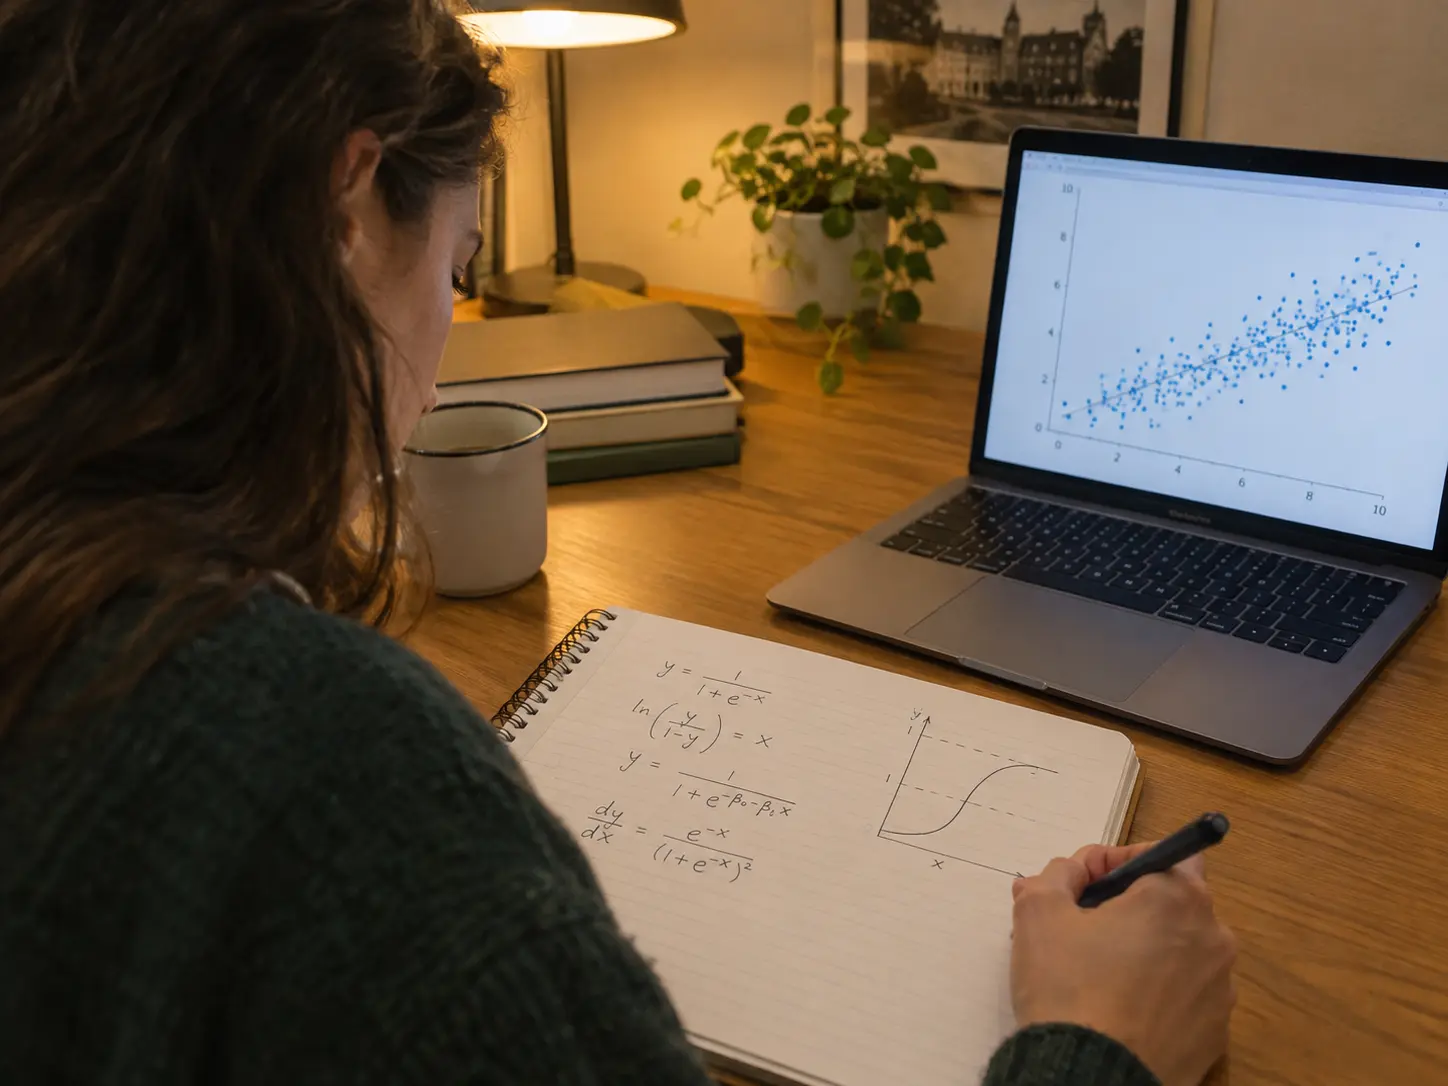
La regresión lineal estima el valor esperado de una variable continua (por ejemplo, un puntaje de ansiedad de 0 a 63 en una escala) a partir de otras variables. La regresión logística, en cambio, no predice un puntaje: predice la probabilidad de pertenecer a una categoría. Esa probabilidad se expresa primero como odds (momios: el cociente entre la probabilidad de que ocurra el evento y la de que no ocurra) y después se transforma con la función logit, de modo que la relación con los predictores es lineal en la escala del logaritmo de los odds (log-odds), no en la escala original de 0 a 1.
Esa distinción es exactamente lo que un jurado pregunta para verificar que entendiste el modelo y no solo lo corriste: en la regresión lineal el coeficiente se lee como «cuánto cambia Y por cada unidad de X»; en la logística, el coeficiente exponenciado (el odds ratio o razón de odds) se lee como «por cuánto se multiplican los odds de que ocurra el evento por cada unidad de X».
Un ejemplo numérico simple ayuda a fijar la idea: si la probabilidad de un evento es 0,20, sus odds son 0,20 / 0,80 = 0,25; si la probabilidad sube a 0,50, los odds pasan a 0,50 / 0,50 = 1. La razón entre ambos odds (1 / 0,25) es 4, aunque la probabilidad solo se multiplicó por 2,5. Por eso el odds ratio y el «cuántas veces más probable» no son lo mismo.
Cómo se interpreta el modelo: odds ratio, coeficientes y significación
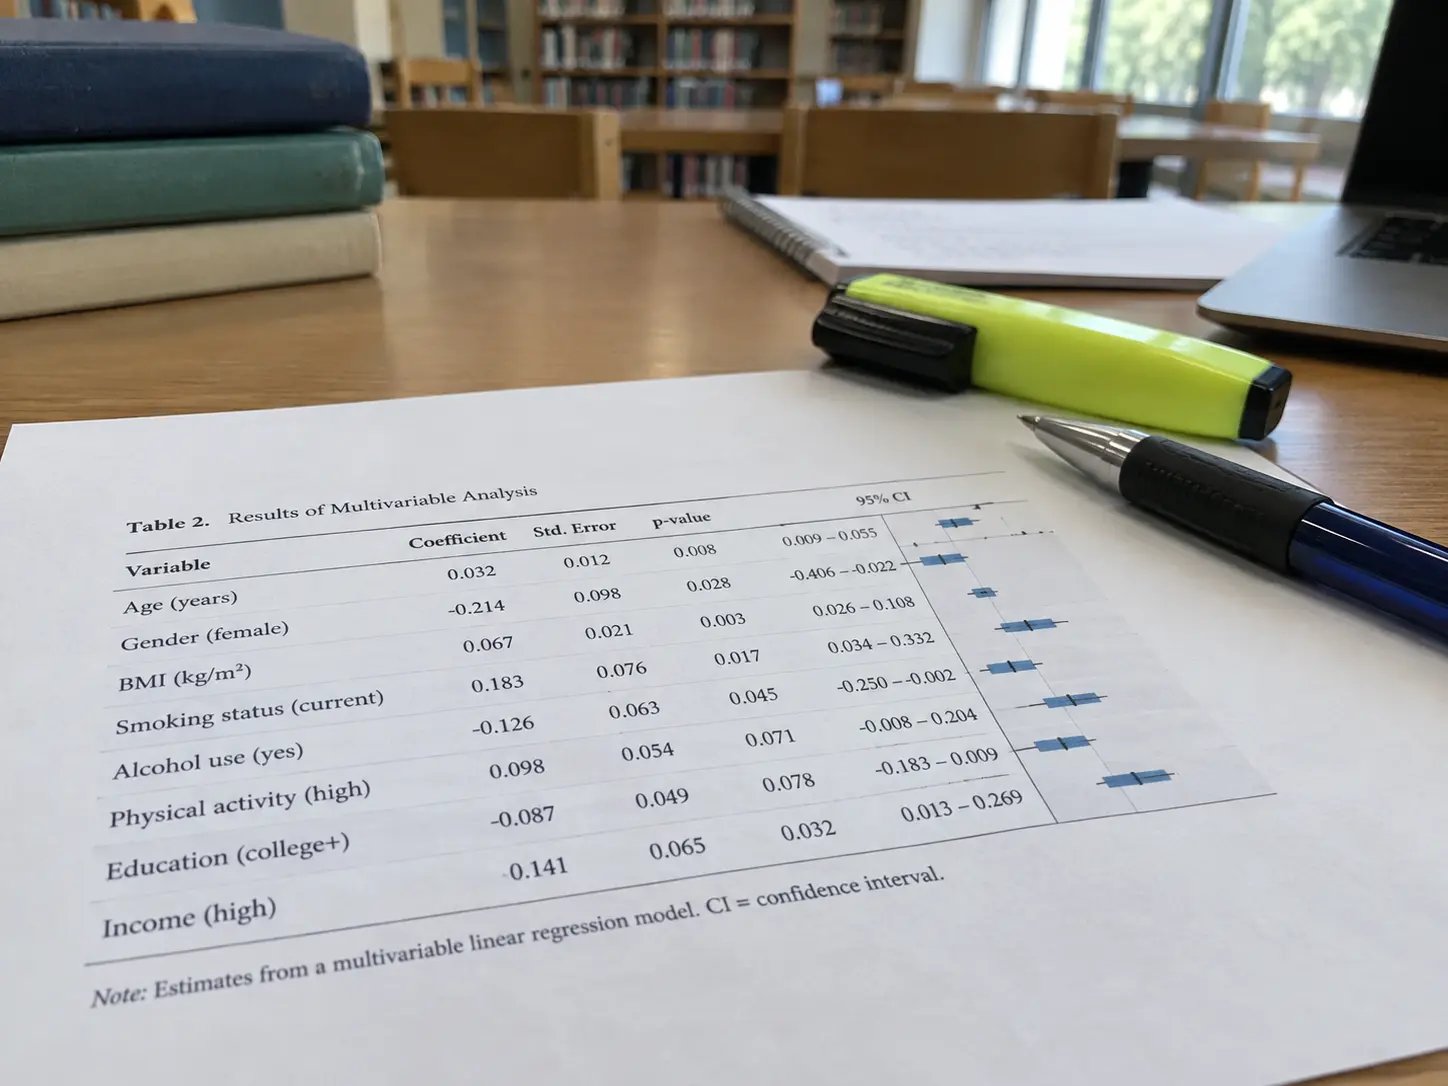
Una tabla de resultados de regresión logística típica en un software estadístico muestra, por cada predictor: el coeficiente B (en escala logit), su error estándar, el estadístico de Wald con su significación, y el Exp(B), que es el odds ratio.
- Odds ratio (OR) mayor a 1: el predictor aumenta la probabilidad del evento. Un OR de 1,8, por ejemplo, indica que los odds del evento se multiplican por 1,8 (un aumento del 80 %) por cada unidad de aumento del predictor, manteniendo las demás variables constantes.
- OR menor a 1: el predictor la disminuye. Un OR de 0,6 indica que los odds se reducen al 60 % de su valor, es decir, una baja del 40 % por cada unidad del predictor.
- OR cercano a 1 con intervalo de confianza que cruza el 1: el predictor no aporta de forma significativa al modelo, aunque el coeficiente en escala logit no sea exactamente cero.
Además del coeficiente por predictor, el capítulo de resultados debe reportar el ajuste global del modelo: el estadístico de razón de verosimilitud (chi-cuadrado del modelo), un pseudo R² (Nagelkerke o Cox y Snell, que no se interpretan igual que el R² de la lineal) y, cuando el software lo ofrece, la prueba de bondad de ajuste de Hosmer-Lemeshow y la tabla de clasificación con el porcentaje de casos correctamente clasificados.
Requisitos y supuestos que hay que verificar antes de correr el modelo
La regresión logística no exige normalidad ni homocedasticidad de los residuos como la lineal, pero sí tiene sus propios supuestos, y omitirlos suele generar observaciones en la defensa:
- Independencia de las observaciones: cada caso debe aportar un dato independiente; si trabajaste con mediciones repetidas en las mismas personas, este modelo simple no aplica y hace falta un modelo de efectos mixtos.
- Linealidad del logit: cada predictor continuo debe tener una relación lineal con el logaritmo de los odds, no con la variable dependiente original. Se verifica con la prueba de Box-Tidwell o inspeccionando el término de interacción entre el predictor y su logaritmo.
- Ausencia de multicolinealidad severa: se revisa con el factor de inflación de la varianza (VIF) entre los predictores.
- Tamaño muestral suficiente por categoría: una referencia orientativa muy citada, derivada del estudio de simulación de Peduzzi et al. (1996) en el Journal of Clinical Epidemiology, es contar con al menos diez casos del grupo menos frecuente (eventos) por cada predictor incluido en el modelo; con muestras chicas, el modelo puede no converger o dar coeficientes inestables, algo que conviene anticipar en el capítulo de limitaciones.
- Ausencia de separación perfecta o casi perfecta: si una categoría de un predictor predice el resultado sin ninguna excepción, el modelo no converge; es un problema técnico que hay que poder explicar si aparece.
Aplicado a números: si tu muestra tiene 150 estudiantes y solo 40 declaran intención de abandono, la regla orientativa de diez eventos por predictor sugiere no pasar de cuatro predictores (40 / 10 = 4). Si querés incluir seis variables, necesitás más casos del grupo menos frecuente o una justificación metodológica explícita.
Ejemplo ilustrativo aplicado a Psicología
El siguiente ejemplo es enteramente ilustrativo y ficticio; sirve para mostrar la estructura del reporte, no para citar cifras reales.
Supongamos una tesina que investiga si el apoyo social percibido y el nivel de estrés académico predicen la intención de abandono de la carrera (sí/no) en estudiantes de segundo año. El modelo, corrido en jamovi con ambos predictores estandarizados, podría reportarse así: «El modelo de regresión logística binaria fue estadísticamente significativo, χ²(2) = valor ilustrativo, p < ,05, y explicó entre un 18 % y un 24 % de la varianza de la intención de abandono (Cox y Snell R² y Nagelkerke R², respectivamente, valores ilustrativos). El apoyo social percibido se asoció con una menor probabilidad de intención de abandono, OR = 0,58 (IC 95% ilustrativo), mientras que el estrés académico se asoció con una mayor probabilidad, OR = 1,9 (IC 95% ilustrativo). El modelo clasificó correctamente un porcentaje ilustrativo de los casos.»
La interpretación en lenguaje llano sería: por cada desvío estándar adicional de apoyo social percibido, los odds de intención de abandono se reducen un 42 % (1 − 0,58 = 0,42), manteniendo constante el estrés; por cada desvío estándar adicional de estrés académico, los odds aumentan un 90 % (1,9 − 1 = 0,9), manteniendo constante el apoyo social.
Notá la estructura: primero el ajuste global del modelo, después cada predictor con su OR e intervalo de confianza, y por último la tabla de clasificación. Es una secuencia fácil de seguir para el jurado y coherente con la recomendación de APA 7 de acompañar cada estimación con su intervalo de confianza y un indicador de tamaño del efecto.
Cómo reportarlo en el capítulo de resultados y en APA 7
En formato APA 7, la tabla de un modelo de regresión logística suele incluir los coeficientes B, el error estándar, el estadístico de Wald, los grados de libertad, la significación y el Exp(B) con su intervalo de confianza al 95 %, además del texto narrativo que resume los hallazgos principales sin repetir cada número de la tabla. Es un error frecuente narrar la tabla entera en el cuerpo del texto: el texto debe destacar los predictores significativos y remitir al lector a la tabla para el detalle completo.
Si tu tesina reporta más de un modelo (por ejemplo, un modelo solo con variables sociodemográficas y después un modelo con las variables psicológicas agregadas), es habitual presentar ambos en pasos o bloques y reportar el cambio en el -2 log de verosimilitud entre uno y otro para justificar que el segundo modelo mejora el ajuste.
Con qué software correrla
jamovi y R son gratuitos y permiten correr regresión logística binaria sin costo; SPSS requiere licencia, que a veces provee la propia facultad. Consultá la comparativa de programas estadísticos para la tesina si todavía no elegiste con cuál trabajar, y el tutorial paso a paso de SPSS si ya tenés acceso. Antes de elegir la logística, repasá el árbol de decisión para elegir la prueba estadística de tu tesina: si tu variable dependiente no es dicotómica, es probable que necesites otro análisis.
Errores frecuentes que devuelve el director/a o marca el jurado
- Confundir el coeficiente B con el odds ratio. El coeficiente B está en escala logit y no se interpreta como «cuántas veces más»; el que se interpreta como factor multiplicativo de los odds es el Exp(B), el odds ratio. Reportar el B y describirlo como si fuera un OR es un error que suele generar devoluciones.
- Correr el modelo sin justificar por qué la variable dependiente se dicotomizó. Si tu variable original era continua (por ejemplo, un puntaje de bienestar) y la convertiste en dos categorías con un punto de corte, el jurado va a preguntar por qué elegiste ese punto de corte y no otro, y perder información al dicotomizar una variable continua es una decisión que hay que justificar en el capítulo metodológico, no solo mencionar en resultados.
- No reportar el intervalo de confianza del odds ratio. El valor puntual del OR sin su intervalo no permite evaluar la precisión de la estimación; APA 7 recomienda acompañar las estimaciones puntuales con sus intervalos de confianza.
- Igualar significación estadística con relevancia práctica. Un predictor puede ser significativo con un OR muy cercano a 1 (por ejemplo, 1,05), lo que indica un efecto real pero de magnitud pequeña; conviene discutir esa distinción en el capítulo de discusión en lugar de presentar cualquier resultado significativo como un hallazgo importante.
- No verificar la razón de casos por predictor antes de correr el modelo. Agregar predictores sin mirar cuántos casos hay en la categoría menos frecuente de la variable dependiente es una causa habitual de que el modelo no converja o de que los errores estándar salgan inflados.
Checklist antes de llevar el capítulo al director/a
- ¿Tu variable dependiente es dicotómica, y está codificada 0/1 de forma consistente en toda la base?
- ¿Verificaste la linealidad del logit para cada predictor continuo?
- ¿Calculaste el VIF para descartar multicolinealidad entre los predictores?
- ¿La razón de casos por predictor en la categoría menos frecuente es razonable para el tamaño de tu muestra?
- ¿Tu tabla de resultados incluye B, error estándar, Wald, gl, significación, Exp(B) e IC 95 % para cada predictor?
- ¿Reportaste el ajuste global del modelo (chi-cuadrado, pseudo R², clasificación) antes de entrar en cada predictor?
- ¿El texto narrativo interpreta los odds ratio en lenguaje llano, sin repetir cada celda de la tabla?
Si tu tesina compara varios modelos anidados (por bloques o por pasos), agregá una fila al checklist para el cambio en el -2 log de verosimilitud entre modelos y para la justificación teórica de por qué cada bloque de variables entra en ese orden y no en otro.
Preguntas frecuentes
¿La regresión logística sirve para tesinas cualitativas?
No. Es un análisis cuantitativo que requiere una variable dependiente categórica medida en una muestra con un tamaño adecuado; en un diseño cualitativo no tiene sentido aplicarla.
¿Cuántos predictores puedo incluir en el modelo?
Depende del tamaño de tu muestra y de la proporción de casos en la categoría menos frecuente de la variable dependiente; como orientación metodológica general, cuantos menos casos tengas en esa categoría, menos predictores deberías incluir para evitar coeficientes inestables.
¿Qué diferencia hay entre el odds ratio y una probabilidad?
El odds ratio compara los odds (momios) entre dos condiciones, no es directamente una probabilidad. Un OR de 2 no significa «el doble de probable»; significa que el cociente entre la probabilidad de que ocurra el evento y la de que no ocurra se duplica.
Armá el capítulo de resultados con Tesify
Tesify te ayuda a estructurar y redactar el capítulo de resultados de tu tesina, ordenar las tablas de tu modelo estadístico y revisar la coherencia con tu marco metodológico, sin reemplazar tu criterio ni el análisis que ya corriste en tu software. Empezá gratis, sin tarjeta.